
大模型微调如何突破学习瓶颈?RLTL;DR 自生成反馈内化方法解析
强化学习可验证奖励(RLVR)在任务过难、128 次尝试仍无解时会陷入「学习瓶颈」,梯度信号归零。本文解读 Apple 的 RLTL;DR:让智能体每次失败后自写一句 TL;DR 心得并内化进权重,在 Pass@128=0 的难题集上把 Pass@1 从 0–1% 提升到 12–13%(评估时不含心得)。

强化学习可验证奖励(RLVR)是当下让大模型学会推理、工具调用和编码的主流后训练范式:让策略对同一任务做多次尝试,再用验证器(单元测试、最终状态检查)判定对错,只朝成功的那次优化。但这套范式有一个致命盲区——当任务难到 128 次尝试仍无一次成功时,所有 rollout 拿到相同奖励,组内优势(advantage)坍缩为零,梯度信号随之消失。作者把这道坎命名为学习瓶颈(learning barrier)。来自 Apple 机器学习团队、由 Michael Kirchhof、Alexander Toshev 等九位研究者完成的论文《RLTL;DR: Self-improvement by Internalizing Self-generated Feedback》(arXiv:2609.37633,NeurIPS 2026)提出 RLTL;DR:让智能体在每次失败后自己写一句 TL;DR 心得,并把这份心得内化进模型权重,从而在没有外部教师、没有标准答案的"自我改进"场景里突破学习瓶颈。
RLVR 为什么会在难题上失灵
先拆解 RLVR 的学习机制。以 **GRPO(分组相对策略优化)**为例,它对同一道题采样一组回答,用组内相对分数构造优势,再据此更新策略。这套机制的前提是组内至少要有一两个成功样本,否则优势处处为零,优化方向就断了。
作者特别强调了一个更苛刻的现实:在智能体编码、工具调用这类自我改进场景里,模型往往已经处在能力前沿——没有更强的教师模型可蒸馏,也没有标准答案可抄,只能靠自己一步步探索。此时难题集合天然落在"学习瓶颈之外",也就是 GRPO 完全学不动的区域。论文把训练集专门筛成 Pass@128=0 的子集:起始策略 Qwen 3.5 9B Thinking 在这 128 次尝试里一次都没成功过。
方法:让失败自己说话,再把心得内化进权重
RLTL;DR 在 RLVR 上做了两处关键改动,思路都指向"从自己的失败里榨取信号"。
- 从并行改成串行:不再并行采样一批互不相关的 rollout,而是逐次尝试。每次失败后,策略会看到验证器的输出(错误信息、失败原因),然后自己生成一句高层次的 TL;DR 心得,平均约 17 个 token,例如"记得给搜索结果分页"。下一次尝试会把之前积累的所有心得作为额外的上下文带进去。
- 回传心得梯度:在 GRPO 损失之上叠加一个监督微调(SFT)损失,权重 λ=0.5,专门回传那些心得 token。目的不是让模型"预测心得",而是把"任务 → 心得"的映射直接烙进权重——这样即使评估时不给任何心得,模型也表现得像"心里装着提示"一样。
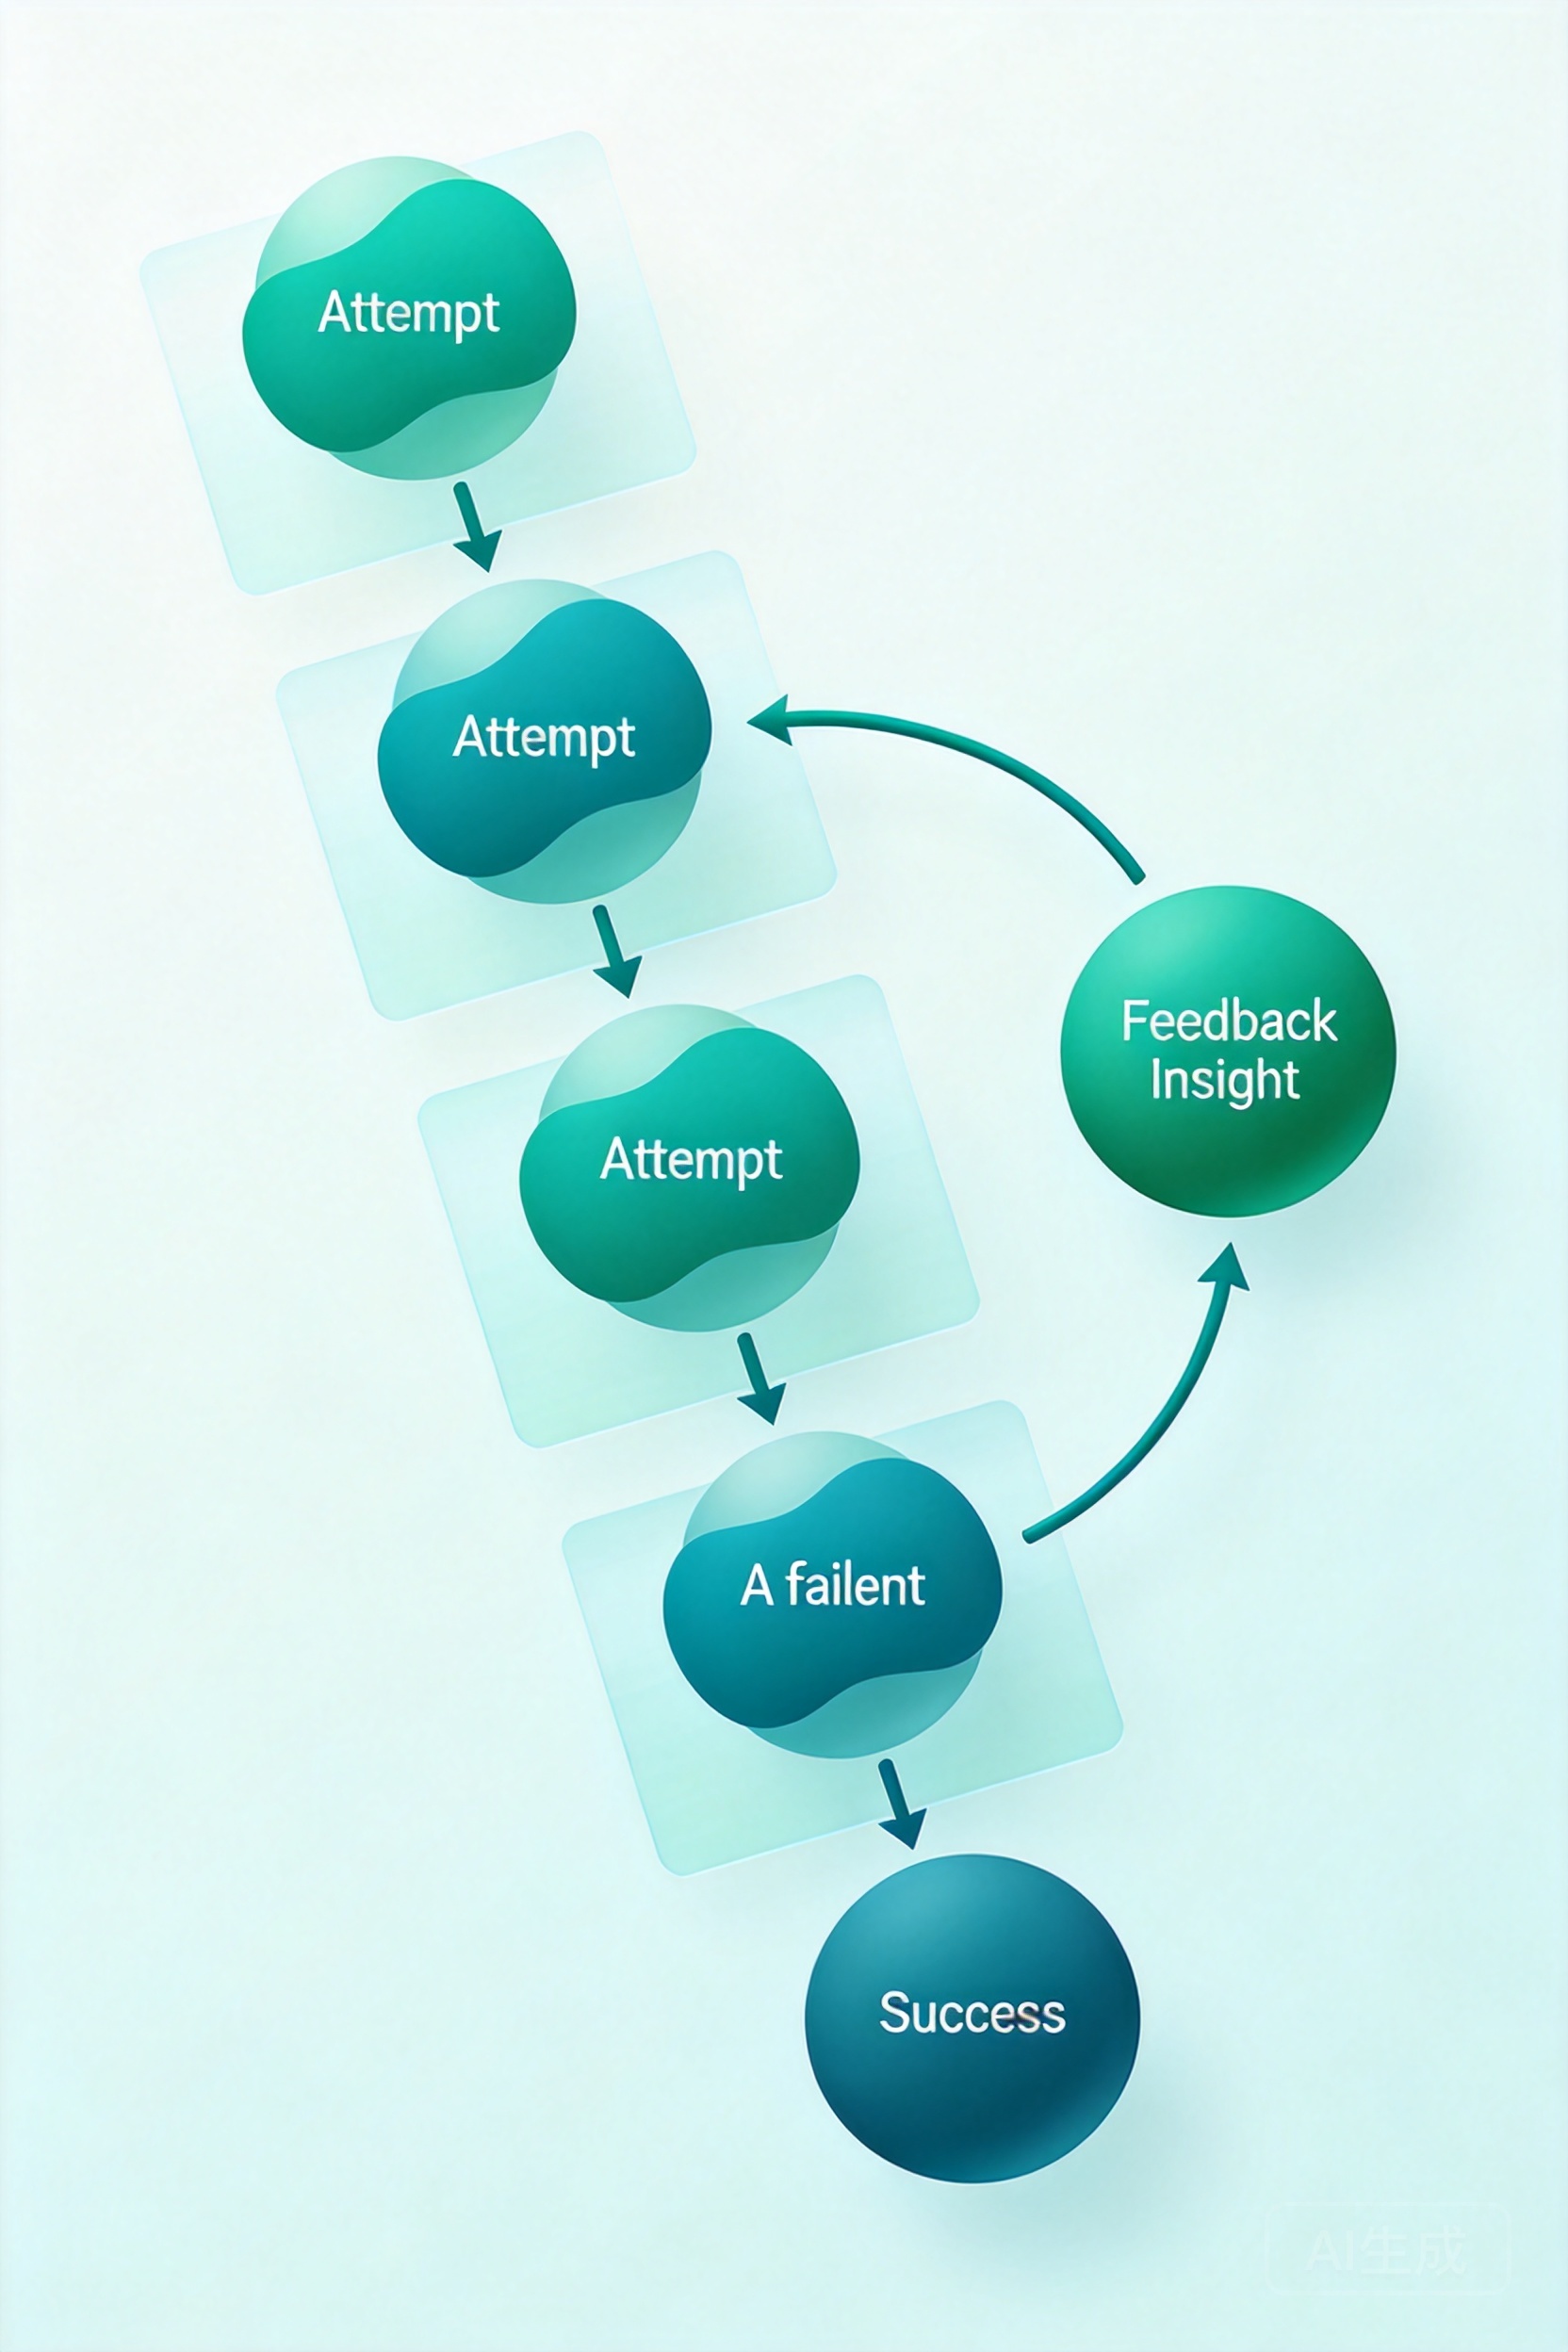
一个值得注意的实现细节:心得只在当前批次成功率 ≤ 50% 时才注入,作者称方法对这一启发式阈值并不敏感。更关键的是,所有评测指标都做了严格的"去混杂"(deconfound)——训练曲线和评估数字只统计"上下文里不含心得"的 rollout,把心得严格当作纯训练辅助,确保报告的提升不是靠"开卷考试"得来的。
实验结果:从 0–1% 到 12–13%,靠的是内化而非提示
论文在三组被筛到"学习瓶颈之外"的数据集上做验证:458 个 SAPI 任务(来自一个 1.6 万任务的专有数据集 Synthetic-API)、34 个 AppWorld 任务、以及 123 道前沿难度的 LeetCode 题。
| 方法 | Pass@1(评估时无心得) |
|---|---|
| GRPO(Qwen 3.5 9B Thinking) | 0–1%(持平不动) |
| RLTL;DR | 12–13% |
对比非常直观:同样的基座、同样的难题集,标准 GRPO 始终卡在 0–1% 不动,而 RLTL;DR 把评估时的 Pass@1 拉到了 12–13%(训练时带着心得更是达到 14–31%)。
作者进一步做了一次"瘦身"实验来定位关键变量。他们把一个简化变体 SFTL;DR 单独拎出来:只训练 (任务, 心得) 二元组,完全不展示、也不回传任何 rollout。结果出乎意料——仅用 4000 个二元组,SFTL;DR 就几乎追平了 RLTL;DR 和经典 SFT 在全量 rollout 上的表现。这直接证明:突破学习瓶颈的核心,是"任务 → 心得"的映射被内化,而非 rollout 本身。
作者把这种范式概括成一句颇有启发性的话——“遇到这类任务时,脑子里要装着这类事”(on this sort of task, keep this sort of thing in mind),并希望它能启发后续研究。
行业启示
这篇工作对指令对齐与数据工程两个技术方向都有直接价值。
在指令对齐层面,RLTL;DR 揭示了一条被忽视的信号来源:在难题上,“失败原因"本身就是高质量的对齐信号。传统 RLVR 只奖励成功,把失败一律判负,等于白白丢掉了失败里蕴含的"下一步该注意什么"的信息。把失败翻译成心得并内化,本质上是把稀疏的奖励信号稠密化,这与 GRPO 及其变体(如 GAR 的梯度对齐奖励)追求的方向一致,但走的是"自生成反馈"而非"外部规则"的路子。在数据工程层面,SFTL;DR 的 4000 个 (任务, 心得) 二元组就能逼近全量 rollout 训练的效果,说明一份精炼的"任务—心得"数据集,其价值密度远高于原始 rollout 语料——这对做领域大模型训练、需要反复构造训练数据的团队来说,是一个值得借鉴的"用更少、更精的数据撬动更强能力"的思路。当然,该工作目前主要在 9B 规模、工具调用与编码任务上验证,心得生成的稳定性与更大基座上的复现仍是后续要观察的方向。
相关问题
Q:什么是 RLVR 的「学习瓶颈」(learning barrier)?
A:当任务难到策略在多次尝试(如 128 次)内没有任何一次成功时,组内所有 rollout 拿到相同奖励,优势坍缩为零、梯度信号消失,训练循环就无法启动。作者把这种现象称为学习瓶颈,并专门筛出 Pass@128=0 的难题集来验证方法能否突破它。
Q:RLTL;DR 和普通 GRPO 训练有什么不同?
A:两个关键改动。一是把并行 rollout 改成串行,每次失败后让策略根据验证器输出自写一句 TL;DR 心得,并带入下一次尝试;二是在 GRPO 损失上叠加一个 SFT 损失回传心得 token,把「任务 → 心得」的映射内化进权重。这样评估时不给心得,模型也像"装着提示"一样表现更好。
Q:SFTL;DR 只训练 4000 个 (任务, 心得) 二元组,为什么就能追平全量 rollout 训练?
A:因为它证明了突破学习瓶颈的核心是「任务 → 心得」映射的内化,而不是 rollout 本身。只要把"遇到这类任务时该注意什么"精炼成心得并直接监督,就能以远低于全量 rollout 的更新成本逼近同等性能,说明这类精炼数据的价值密度很高。
参考文献
📄 论文原文信息
| 论文标题 | RLTL;DR: Self-improvement by Internalizing Self-generated Feedback |
| 作者 | Michael Kirchhof, Eleonora Gualdoni, Andrew Szot, Khashayar Gatmiry, Aryo Lotfi, Abbas Kazerouni, Omar Attia, Sanjoy Chowdhury, Alexander Toshev |
| 期刊 | NeurIPS 2026 |
| 发表时间 | 2026-09-29 |
| DOI | 10.48550/arXiv.2609.37633 |
论文原文信息地址:https://www.simolm.com/blog/2026-10-02-rltldr-self-improvement-feedback-internalization/