
大模型量化部署如何兼顾预填充与解码?Disaggregated Quantization 分阶段量化方法解析
预填充偏计算、解码偏内存,传统量化难以两全。本文解读 Disaggregated Quantization(DQ)分阶段量化:为预填充训练 NVFP4 专用权重、解码保留低比特权重,在 Qwen3.8-27B 上以 1 比特预算将 MMLU-Pro 提升 32.5 分,并带来 1.78 倍首字延迟加速。

大语言模型的推理服务正被两个截然不同的瓶颈同时拉扯:预填充(prefill)阶段是计算密集型,解码(decode)阶段是内存带宽密集型。这一差异意味着"一刀切"的低比特量化(quantization)注定顾此失彼——用低精度算术加速预填充的量化策略,往往拖累了依赖紧凑权重降低内存流量的解码阶段,反之亦然。来自 Andrei Panferov、Tijmen Blankevoort、Dan Alistarh 等作者(含 IST Austria 与 Neural Magic 背景)的论文《Disaggregated Quantization: Specializing LLM Prefill and Decode》(arXiv:2609.26333)提出了一个直观但此前被忽略的方案:把预填充和解码的量化策略"拆开",分别用最适合各自的格式、权重和存储布局去服务。
为什么预填充和解码要分开量化
要理解这篇工作,先得看清两个阶段在硬件上的不同处境。
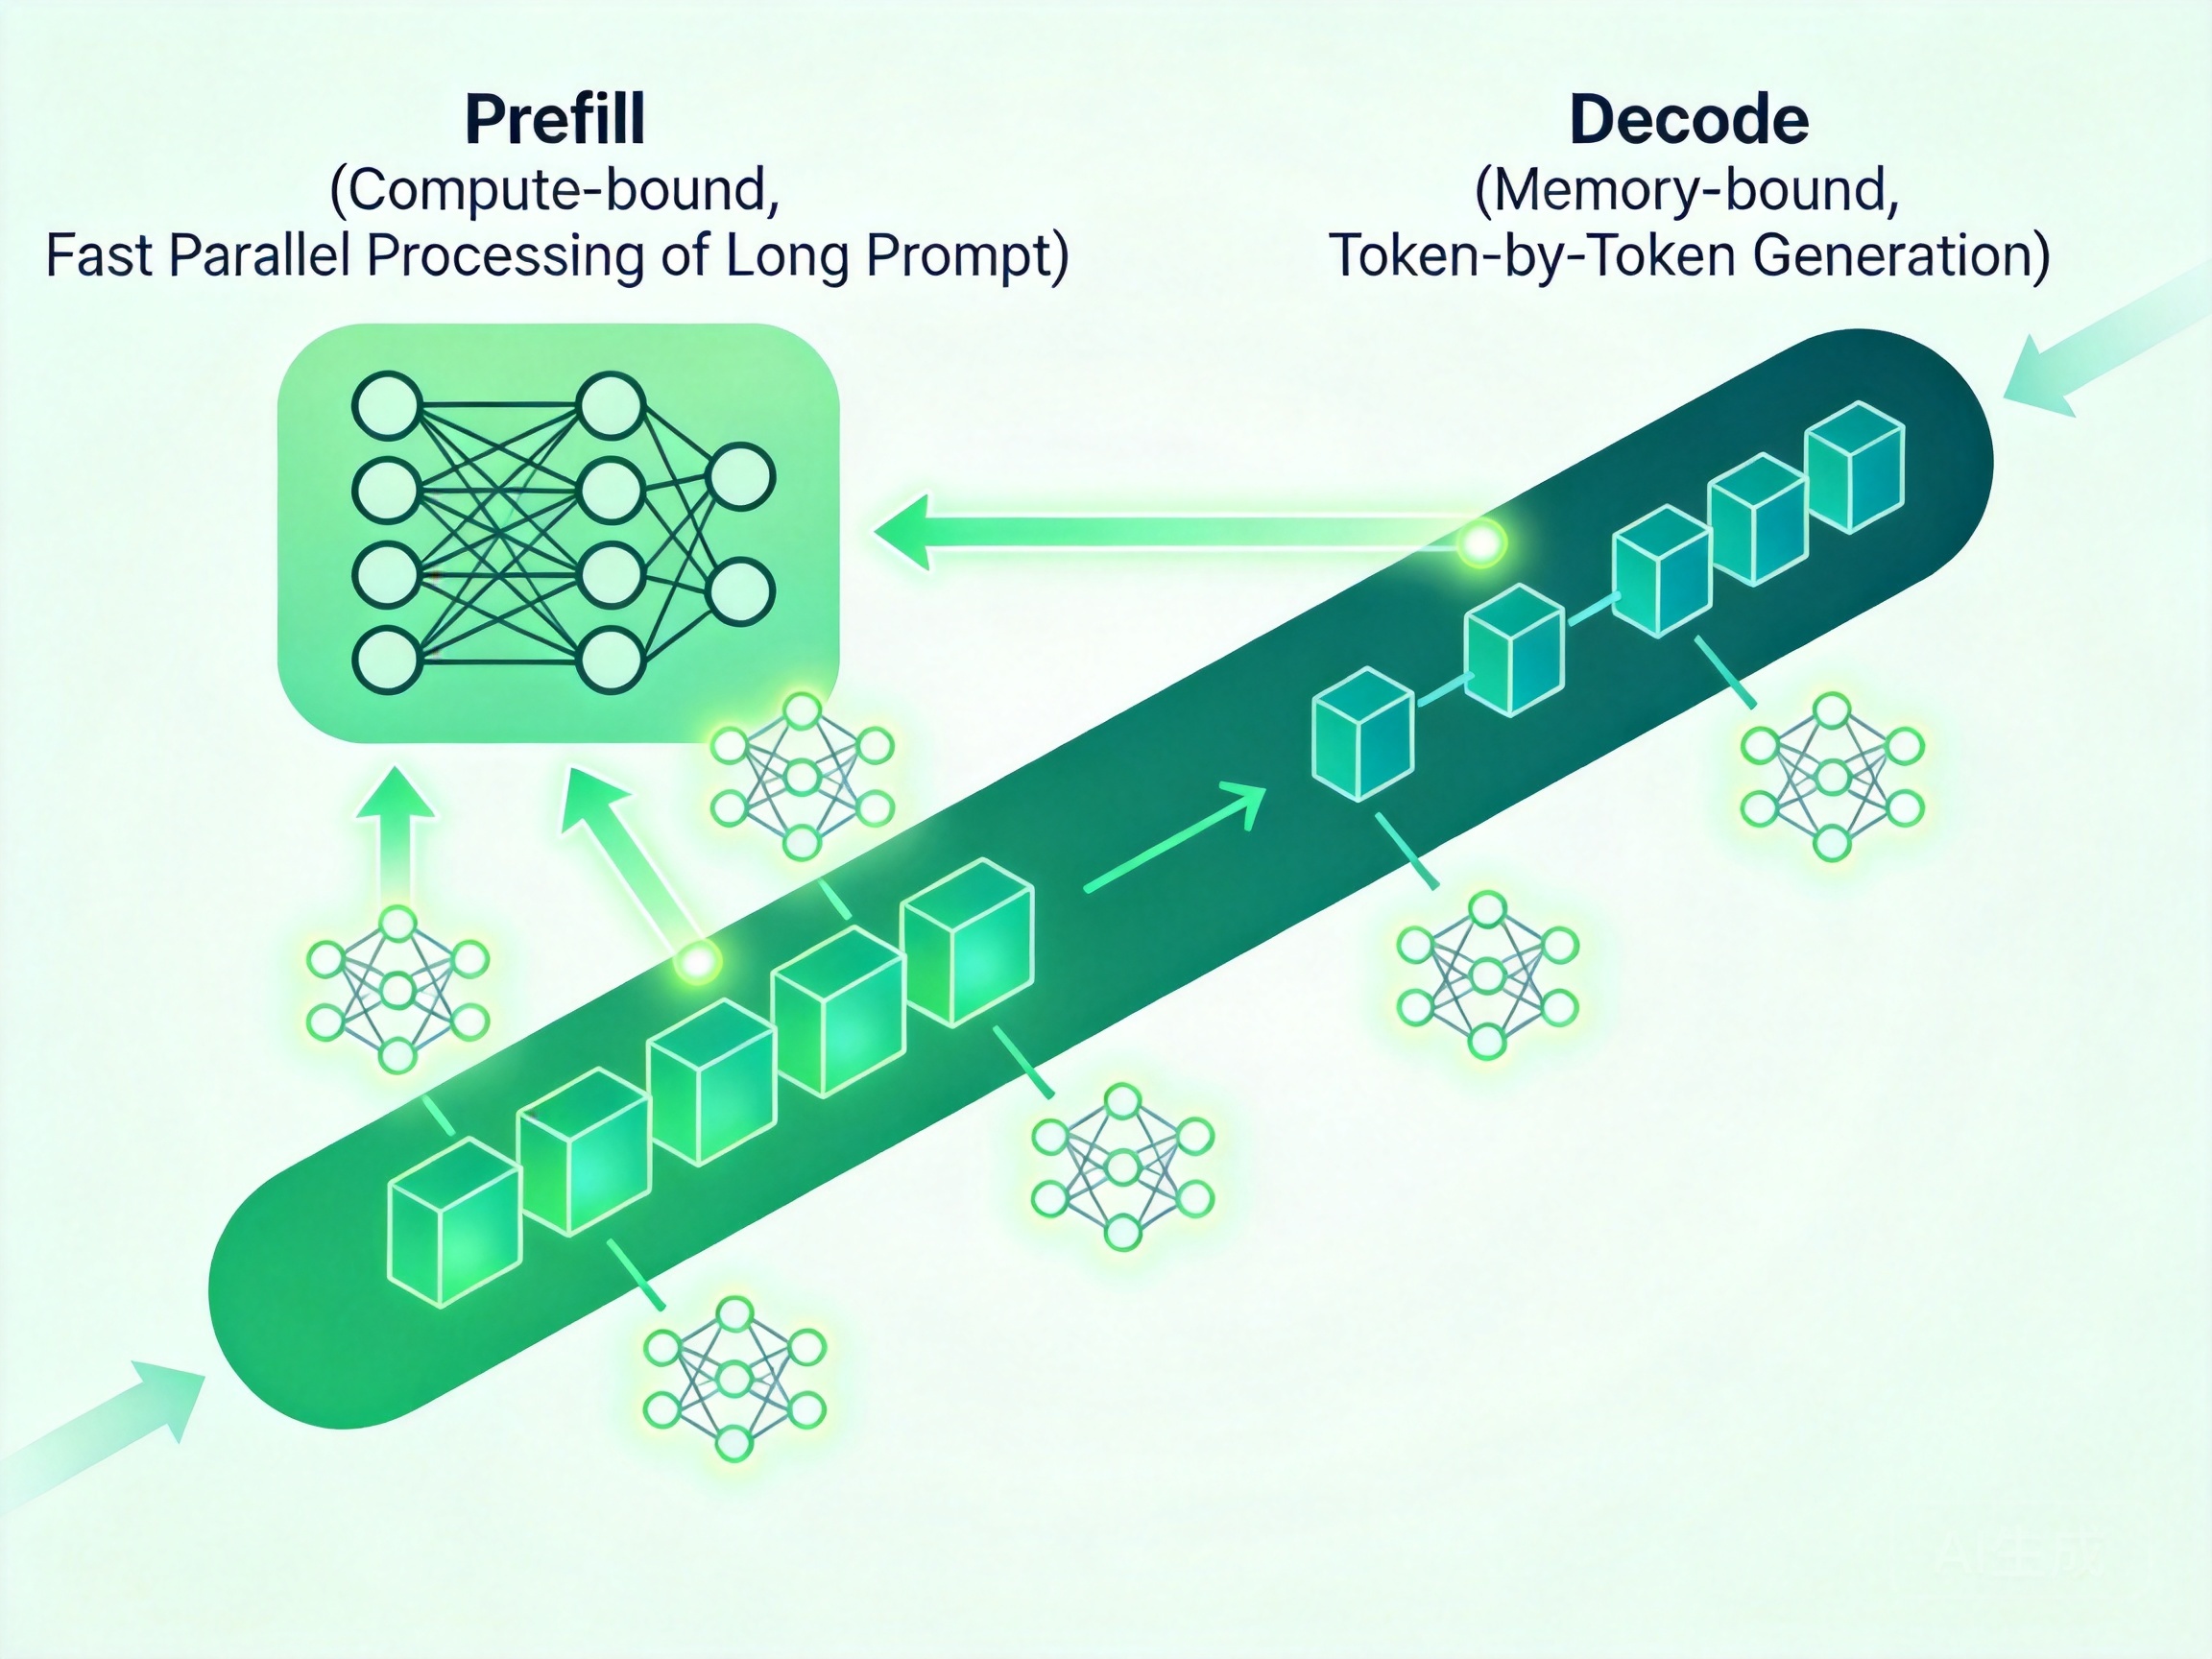
预填充是一次性吃进整段 prompt,逐层做前向计算,这一过程受限于算力(compute-bound)。因此更激进的低精度算术(如 4 比特甚至 1 比特的矩阵乘法)能直接换来更短的"首字延迟"(time-to-first-token,TTFT)。解码则是逐个 token 自回归生成,每一步都要把整份权重从显存/内存里读一遍,受限于内存带宽(memory-bound),此时权重的"紧凑程度"(每参数占多少字节)才是关键,激活量化反而可能带来精度损失而几乎不省带宽。
传统量化方法通常对两个阶段套用同一套格式。作者指出这正是浪费:“低精度算术加速预填充"与"紧凑权重减少解码内存流量"是两件可以解耦的事。论文把这套思路命名为分阶段量化(Disaggregated Quantization,DQ)。
方法:为两个阶段各配一套专用权重
DQ 的核心是"按阶段分工”。具体包含三层设计:
- 解码端去掉激活量化:在 Qwen 3 与 Gemma 3 上,作者发现解码阶段移除激活量化即可提升解码密集型任务的精度,而不增加推理成本——因为解码本来就不受算力限制。
- 为预填充单独训练"计算原生"权重:额外训练一套专门为低精度矩阵乘法优化的预填充权重(compute-native prefill weights),用于加速 prompt 处理。这套权重与解码权重解耦,可独立选择量化格式。
- 共享格式 + 按需放置:解码继续沿用主流的 2-3 比特权重,预填充则用 NVFP4 这类 4 比特微缩放格式,二者共享同一套权重格式体系,只是计算与存储布局不同。
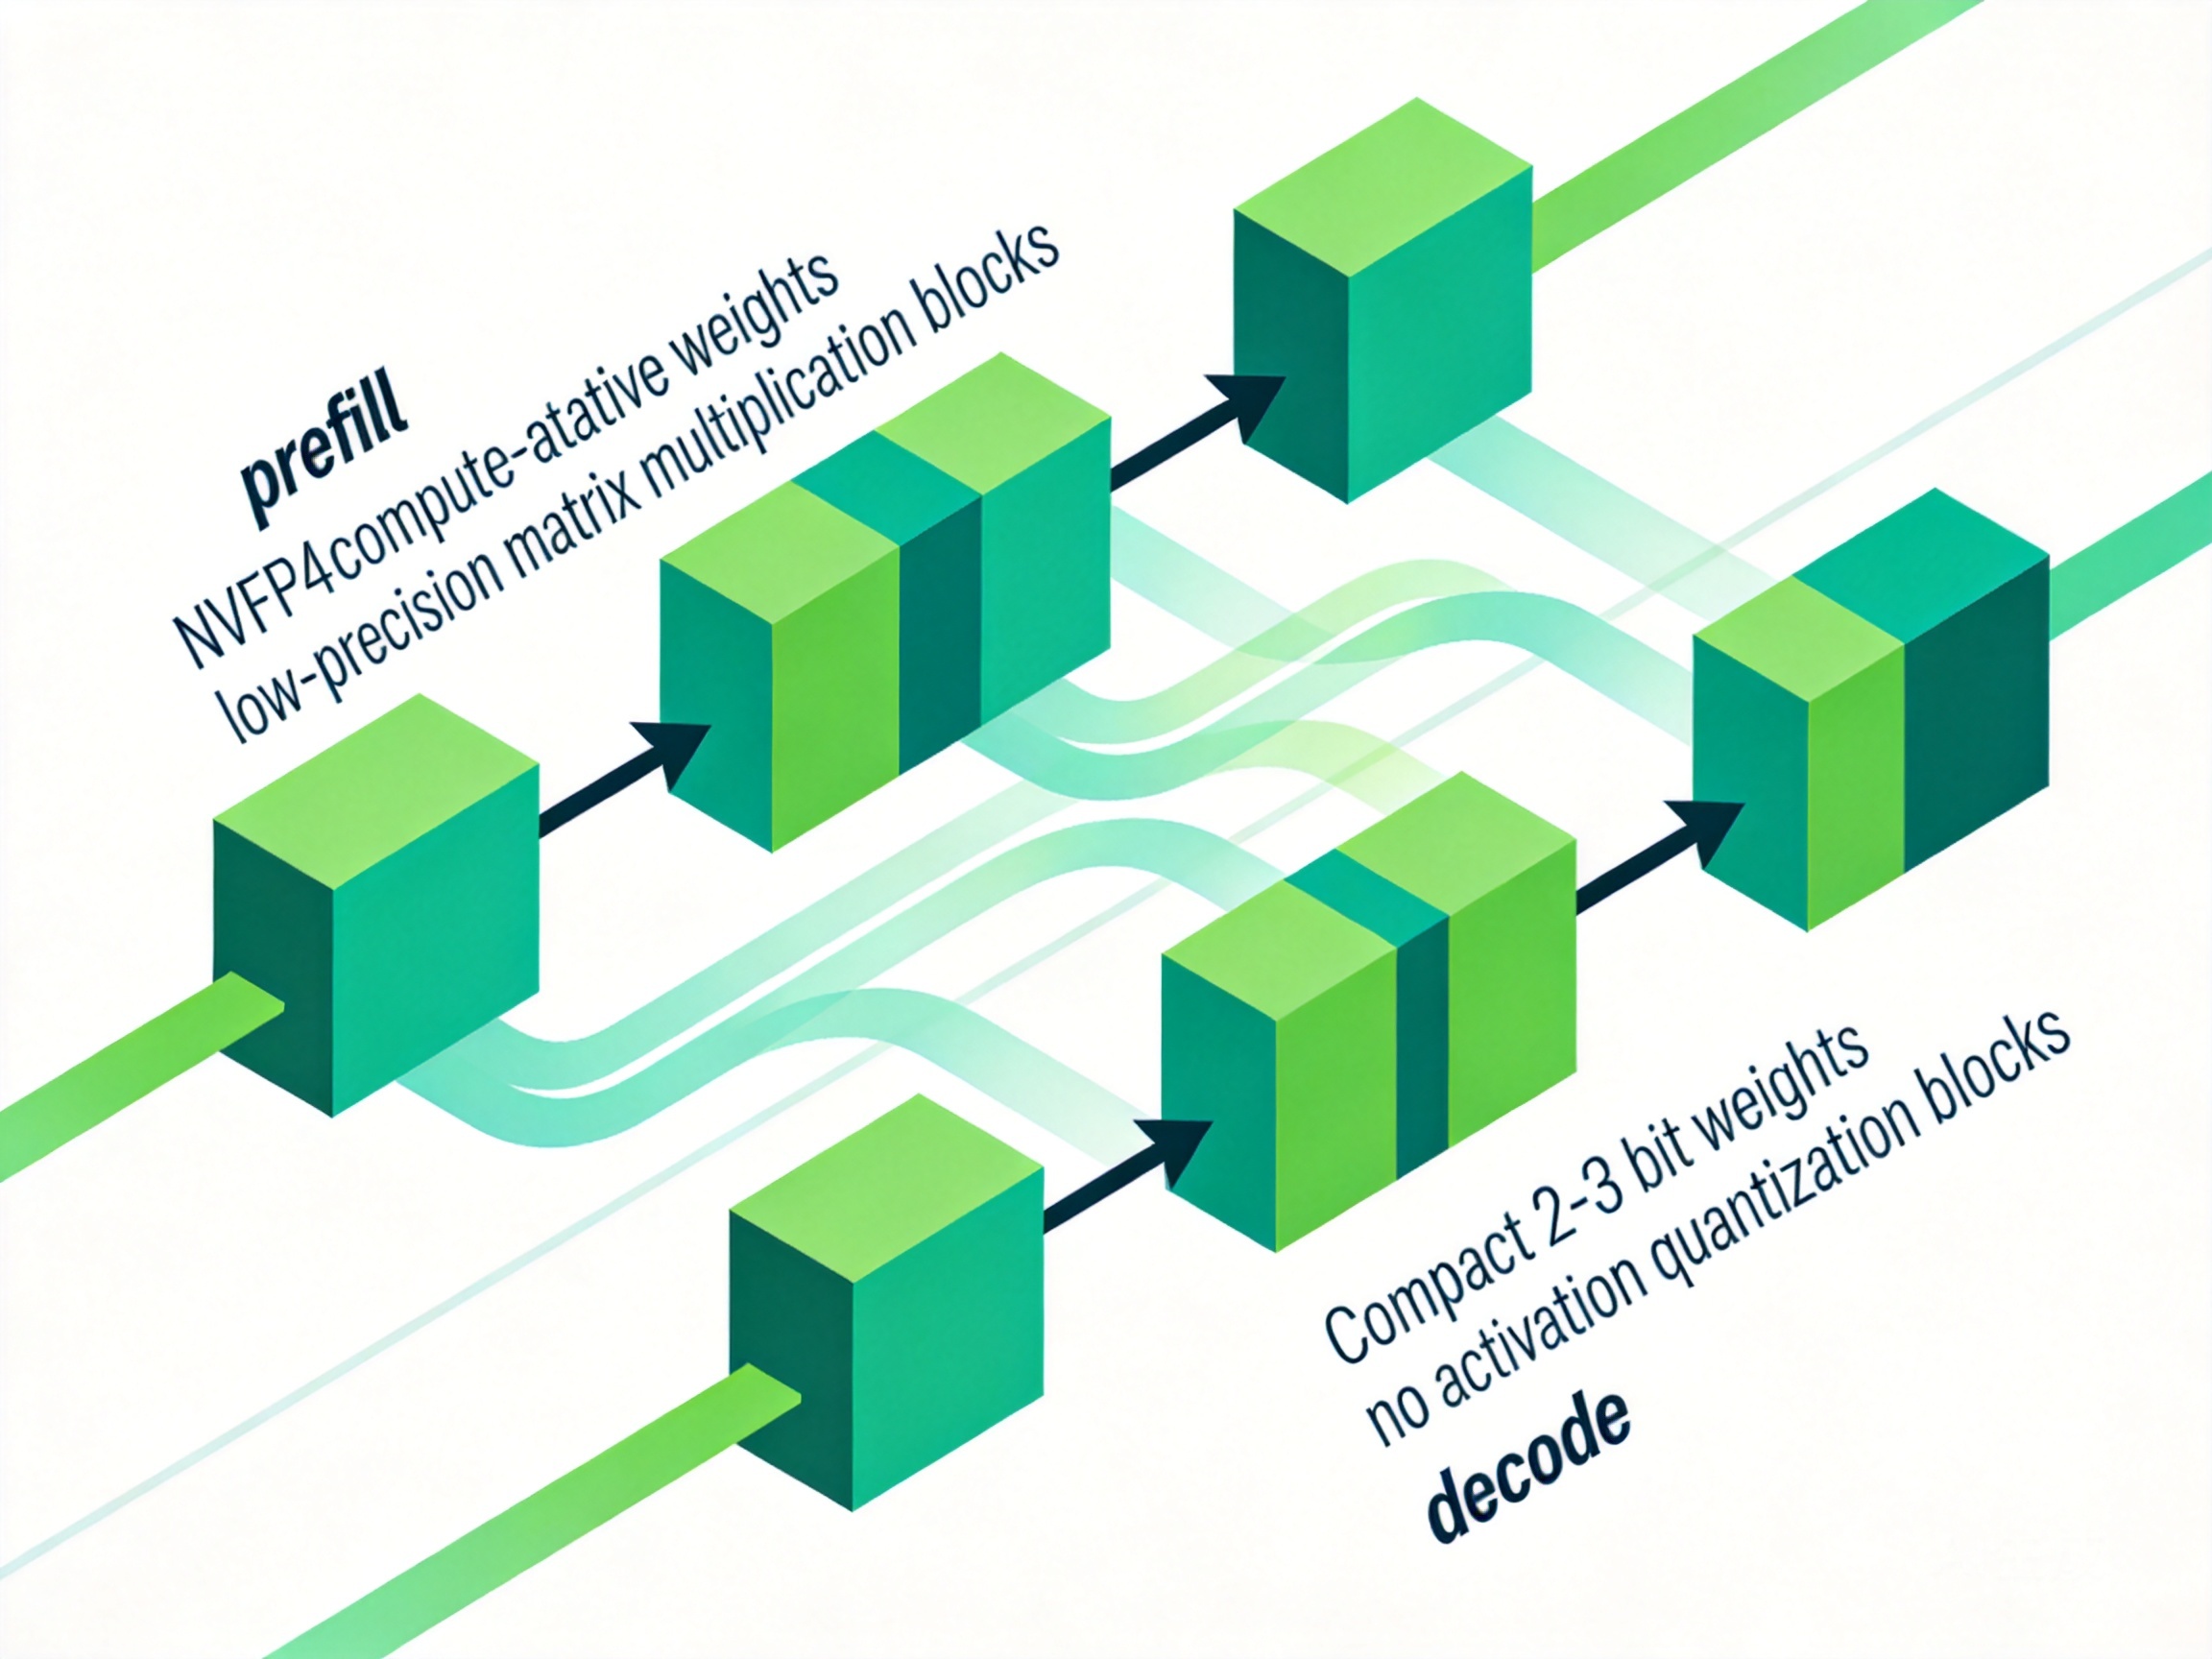
一个关键的工程约束是显存:为预填充单独存一套权重,意味着要多占一份存储。为此论文给出两种落地方式——要么直接双份加载,要么采用卸载式分阶段预填充(offloaded disaggregated prefill,ODP):把预填充权重放在 SSD 上,随 prompt 长度逐步流式加载,把加载开销摊薄到整个预填充过程里。
实验结果:1 比特预算下的精度与速度双赢
论文在多个模型上做了系统验证,几个关键数字相当有说服力:
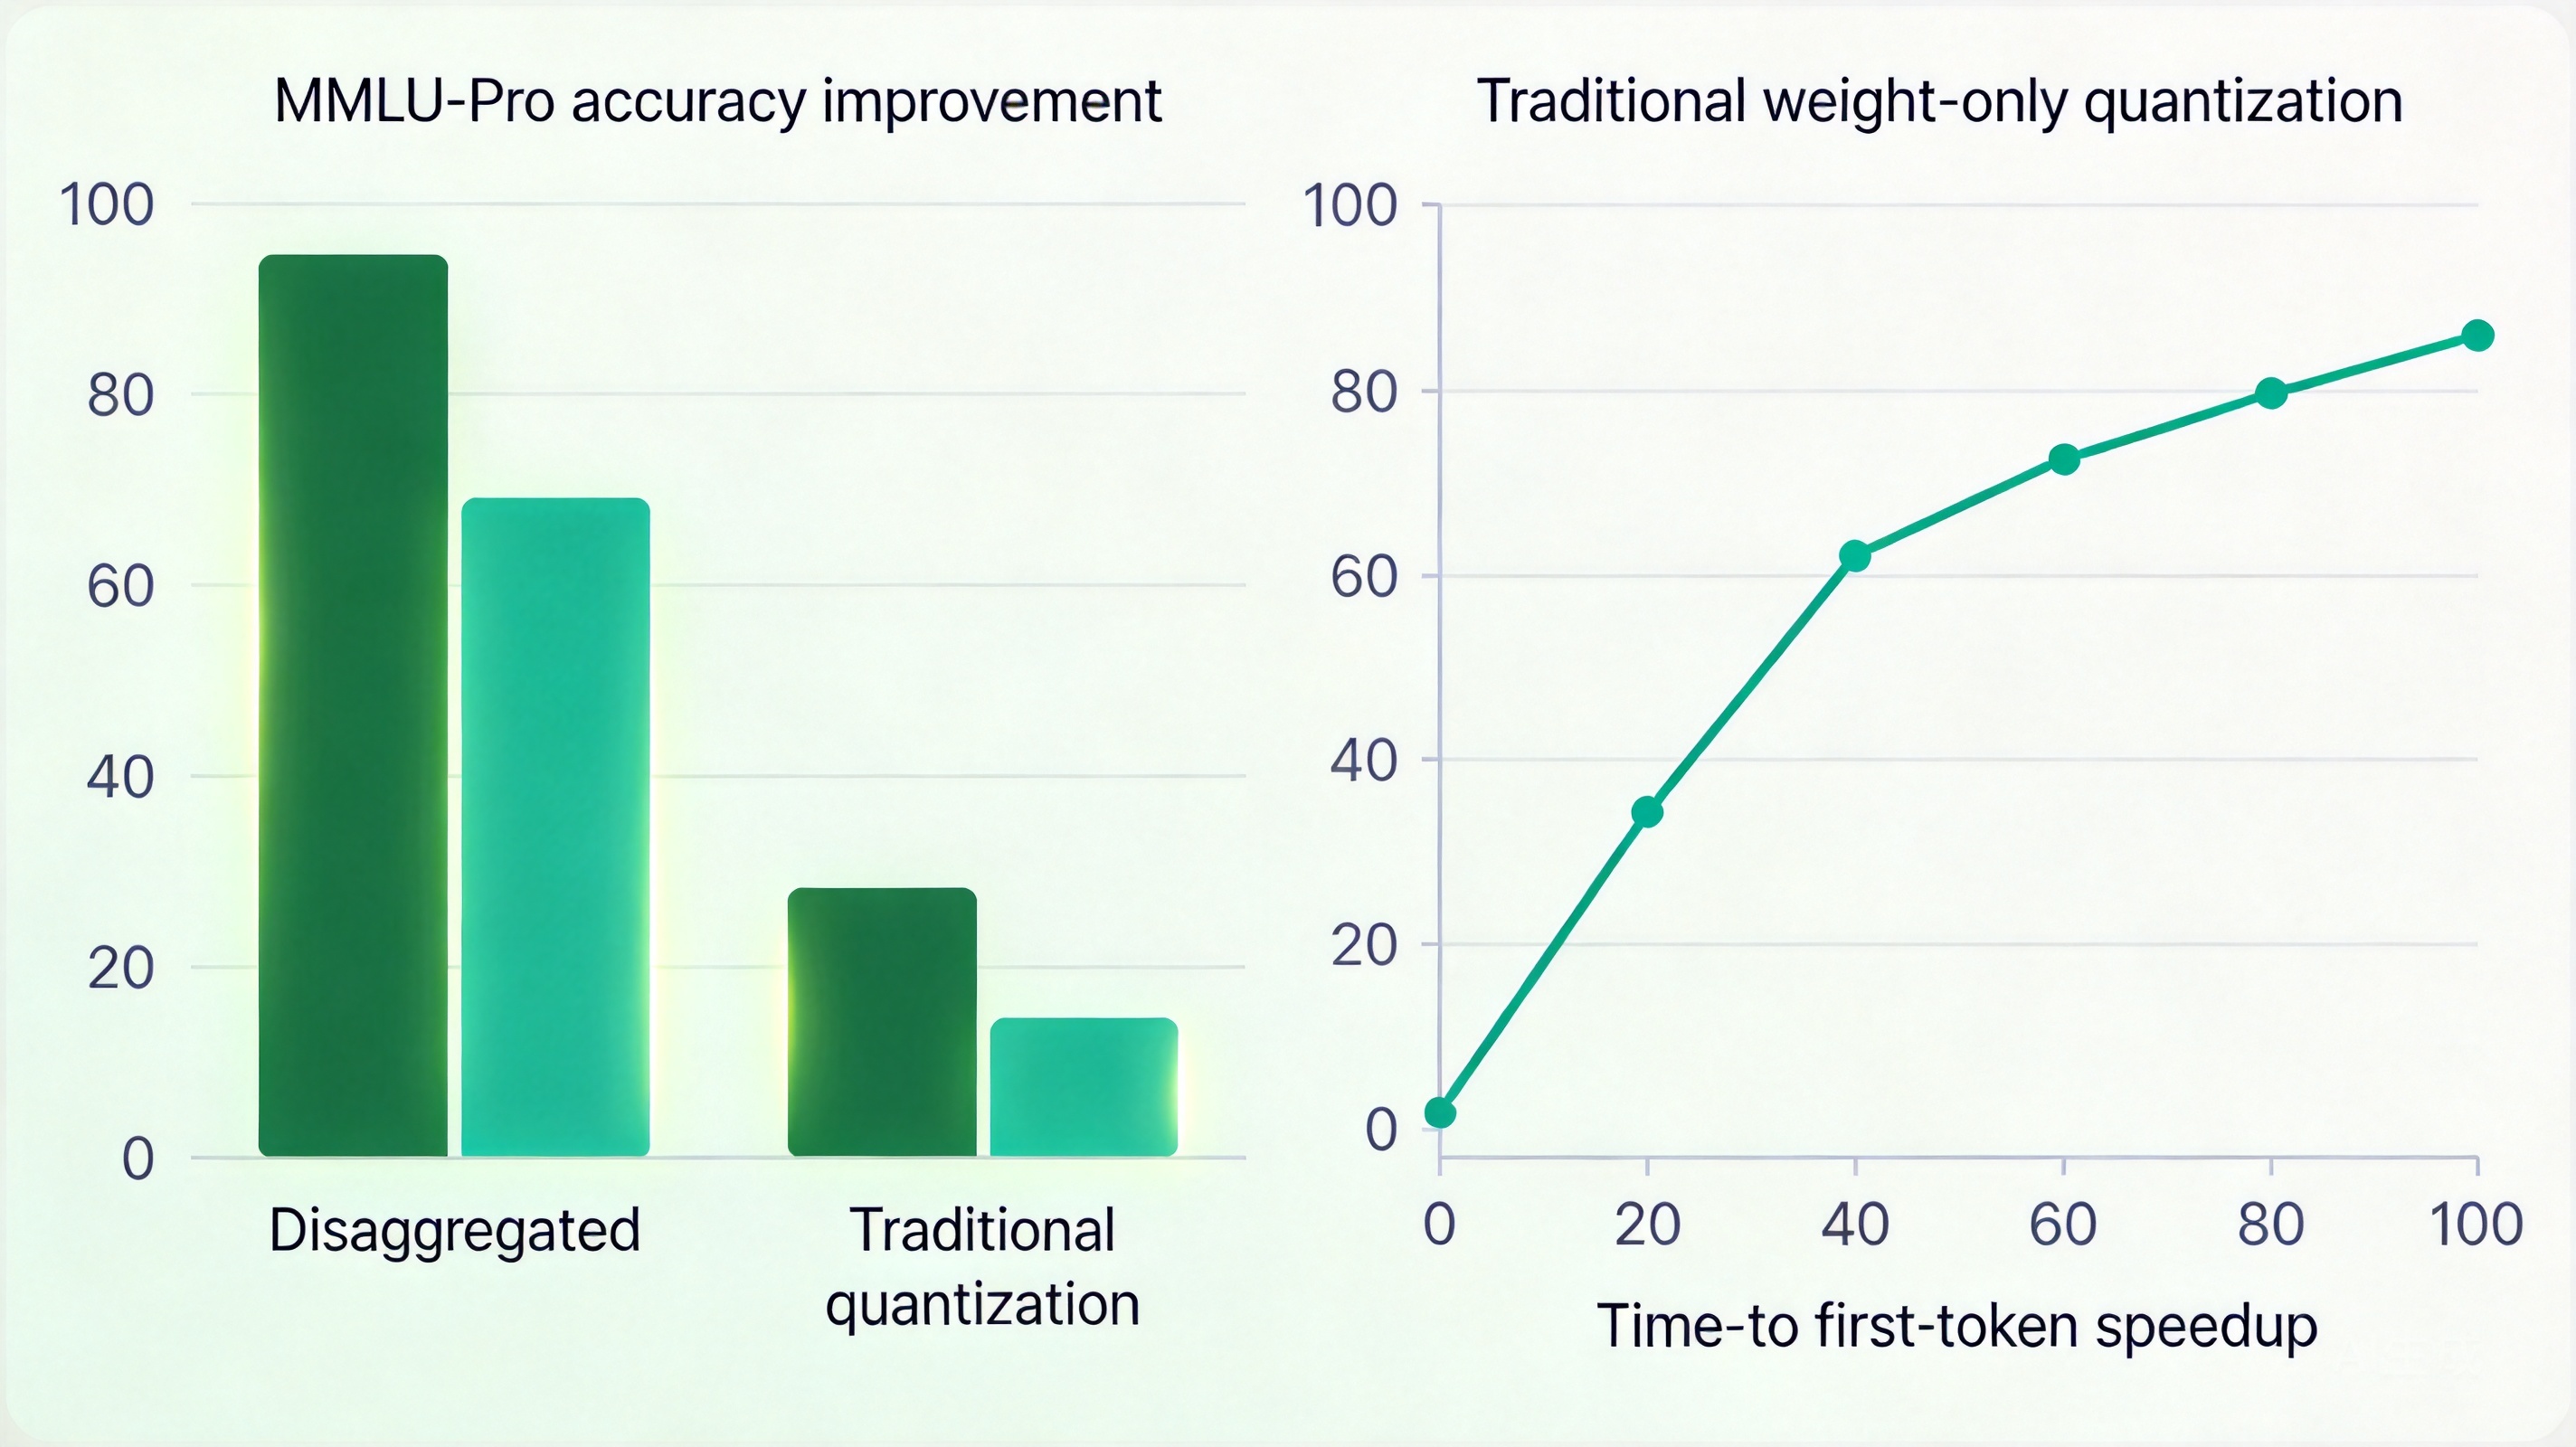
- 精度显著回补:以开源的 Qwen3.8-27B GGUF 解码权重为基座,训练一套 NVFP4 预填充权重,在不动解码 checkpoint 的前提下,把 1 比特量化的精度在 MMLU-Pro 上提升 32.5 分、在 MMMU-Pro 上提升 35.3 分。
- 速度实打实提升:在同一 27B 模型上,ODP 在 8K prompt 长度下相对 weight-only 基线实现了 1.78 倍的首字延迟加速。
- 准确率不降反稳:在 vLLM 中评估分阶段服务时,2-3 比特解码在解码密集与预填充密集两类任务上都匹配或超过 weight-only 推理的准确率。
| 对比维度 | 分阶段量化(DQ) | 传统 weight-only 量化 |
|---|---|---|
| 预填充权重 | 独立 NVFP4 计算原生权重 | 与解码共用一套 |
| 解码激活量化 | 移除,降低精度损失 | 通常保留 |
| MMLU-Pro(1 比特) | 提升 32.5 分 | 基线 |
| 首字延迟(8K prompt) | 1.78 倍加速 | 基线 |
| 额外存储 | 多一份预填充权重(可用 SSD 卸载) | 无 |
作者还进一步验证了方法的可扩展性:通过对最高达 2.8 万亿参数的模型做后训练量化(PTQ),确认"共享格式的分阶段量化"在大规模模型上同样成立,而不只是小模型上的玩具实验。
行业启示
这篇工作对"推理部署"这一技术方向有直接的工程价值。它把一个常被忽略的事实摆上台面:量化不是"找一套格式套全流程",而是要在"计算"与"内存"两个维度上做精确的资源分配。
对大模型微调后要做私有化、边缘化部署的团队来说,这提供了一条清晰的可操作路径:基座模型经领域适配训练得到业务权重后,在服务层为预填充和解码分别选型量化格式,用卸载式预填充解决显存吃紧的问题,从而在几乎不牺牲精度的前提下显著压低 TTFT。对垂直大模型定制类项目而言,这套"预填充专用权重 + 解码紧凑权重"的组合,意味着那些对首字延迟敏感(如实时交互、RAG 长上下文检索)的落地场景,多了一个新的调优旋钮。
相关问题
Q:为什么预填充和解码需要不同的量化策略?
A:预填充一次性处理整段 prompt,是算力受限阶段,低精度算术能直接加速;解码逐 token 生成,每一步都要读整份权重,是内存带宽受限阶段,更需要紧凑的权重而非低精度算术。两者需求不同,所以"一刀切"的量化会顾此失彼。
Q:Disaggregated Quantization 具体是怎么做的?
A:它把两个阶段解耦:解码端移除激活量化以降低精度损失,并为预填充单独训练一套 NVFP4 计算原生权重来加速 prompt 处理;同时保留解码的 2-3 比特紧凑权重。额外那套预填充权重可以放在 SSD 上流式加载(ODP),把存储开销摊薄到整个预填充过程。
Q:量化部署会不会损害大模型微调后的精度?
A:传统做法可能损害,但 DQ 的思路恰恰是反过来补精度。论文在 Qwen3.8-27B 上只训练预填充权重、不动解码 checkpoint,就把 1 比特量化的 MMLU-Pro 精度提升了 32.5 分,说明分阶段量化能在保持甚至提升精度的同时降低部署成本。
参考文献
📄 论文原文信息
| 论文标题 | Disaggregated Quantization: Specializing LLM Prefill and Decode |
| 作者 | Andrei Panferov, Dan Alistarh |
| 期刊 | arXiv preprint arXiv:2609.26333 (cs.LG) |
| 发表时间 | 2026-09-22 |
| DOI | 10.48550/arXiv.2609.26333 |
论文原文信息地址:https://www.simolm.com/blog/2026-09-28-disaggregated-quantization-prefill-decode/